Trong làn sóng ứng dụng Trí tuệ Nhân tạo hiện nay, phần lớn doanh nghiệp bắt đầu bằng việc xây dựng một vài "trợ lý ảo" hoặc chatbot độc lập (standalone agents). Quá trình thử nghiệm (PoC) thường diễn ra nhanh chóng và thuận lợi. Tuy nhiên, khi chuyển từ thử nghiệm sang vận hành thực tế ở quy mô tổ chức — nơi hàng chục phòng ban cùng truy cập vào kho dữ liệu cốt lõi — các bài toán hóc búa bắt đầu xuất hiện:
- Rủi ro an toàn dữ liệu: Làm thế nào để đảm bảo Agent không vô tình đọc hoặc tiết lộ dữ liệu nhạy cảm giữa các phòng ban, khách hàng?
- Ảo giác nghiệp vụ (Business Hallucination): Mô hình ngôn ngữ lớn (LLM) có thể viết code tốt, nhưng nó không thể tự hiểu các định nghĩa nội bộ (ví dụ: thế nào là "khách hàng hoạt động", công thức tính "LTV" chuẩn của công ty là gì).
- Phân mảnh giải pháp (AI Silos): Mỗi phòng ban tự triển khai một framework khác nhau (LangGraph, CrewAI, AutoGen...), khiến hạ tầng phân tán, tốn kém chi phí và không thể tái sử dụng năng lực của nhau.
Mới đây, đội ngũ kỹ thuật của AppsFlyer đã chia sẻ bài viết Scaling agentic AI on Google Cloud: How AppsFlyer built a governed multi-agent platform, mô tả cách họ giải quyết triệt để các rào cản trên để vận hành an toàn hơn 30.000 tác nhân AI mỗi ngày trên hàng trăm Petabyte dữ liệu.
Bài viết này sẽ cùng bạn mổ xẻ chi tiết kiến trúc của AppsFlyer và đúc kết những nguyên lý thiết kế quan trọng cho các doanh nghiệp đang trong quá trình chuyển đổi số và áp dụng AI.
Tóm tắt điểm cốt lõi của kiến trúc AppsFlyer Multi-Agent
- Vận hành quy mô lớn: hơn 30.000 AI Agent hoạt động mỗi ngày trên hàng trăm PB dữ liệu.
- Tuyệt đối cấm Agent viết Raw SQL trực tiếp gửi BigQuery, niêm phong luồng truy vấn qua ChaseSQL.
- Chuẩn hóa tri thức qua Semantic Layer để ngăn chặn hoàn toàn ảo giác nghiệp vụ.
- Cưỡng chế phân quyền ở tầng giao thức Agent-to-Agent (A2A) thông qua phần mở rộng
governance/v1. - Ghi vết và kiểm toán chuỗi suy luận bằng Trajectory Layer trên AlloyDB (pgvector).
1. Bản chất bài toán tại AppsFlyer: Quy mô lớn đòi hỏi kỷ luật kiến trúc cao
AppsFlyer là nền tảng đo lường marketing di động (Mobile Measurement Partner - MMP) hàng đầu thế giới. Hệ thống của họ ghi nhận hàng chục tỷ sự kiện mỗi ngày từ các kênh quảng cáo lớn (Google, Meta, TikTok) và liên tục tính toán các chỉ số kinh doanh sống còn như tỷ lệ giữ chân (Retention), gian lận quảng cáo (Protect360) hay hiệu quả chi phí (ROAS/LTV).
Ở quy mô đó, nếu một Agent tự do sinh mã SQL để truy vấn trực tiếp vào Data Warehouse:
- Một lỗi nhỏ trong câu lệnh có thể quét qua lượng dữ liệu khổng lồ, gây nghẽn tài nguyên và tiêu tốn chi phí điện toán không cần thiết.
- Nguy cơ lộ dữ liệu giữa các khách hàng (multi-tenancy) hoặc giữa các cấp phân quyền nội bộ là hoàn toàn có thể xảy ra nếu chỉ trông cậy vào việc "dặn dò" LLM qua System Prompt.
Đội ngũ AppsFlyer đã đặt ra một nguyên lý thiết kế nhất quán: Mỗi Agent chỉ đóng góp đúng năng lực chuyên môn của nó (Skill). Toàn bộ các khâu còn lại — từ phân quyền, kiểm soát truy vấn dữ liệu, triển khai hạ tầng đến giao diện người dùng — đều do nền tảng (Platform) quản lý tập trung.
2. Mô hình kiến trúc tổng thể
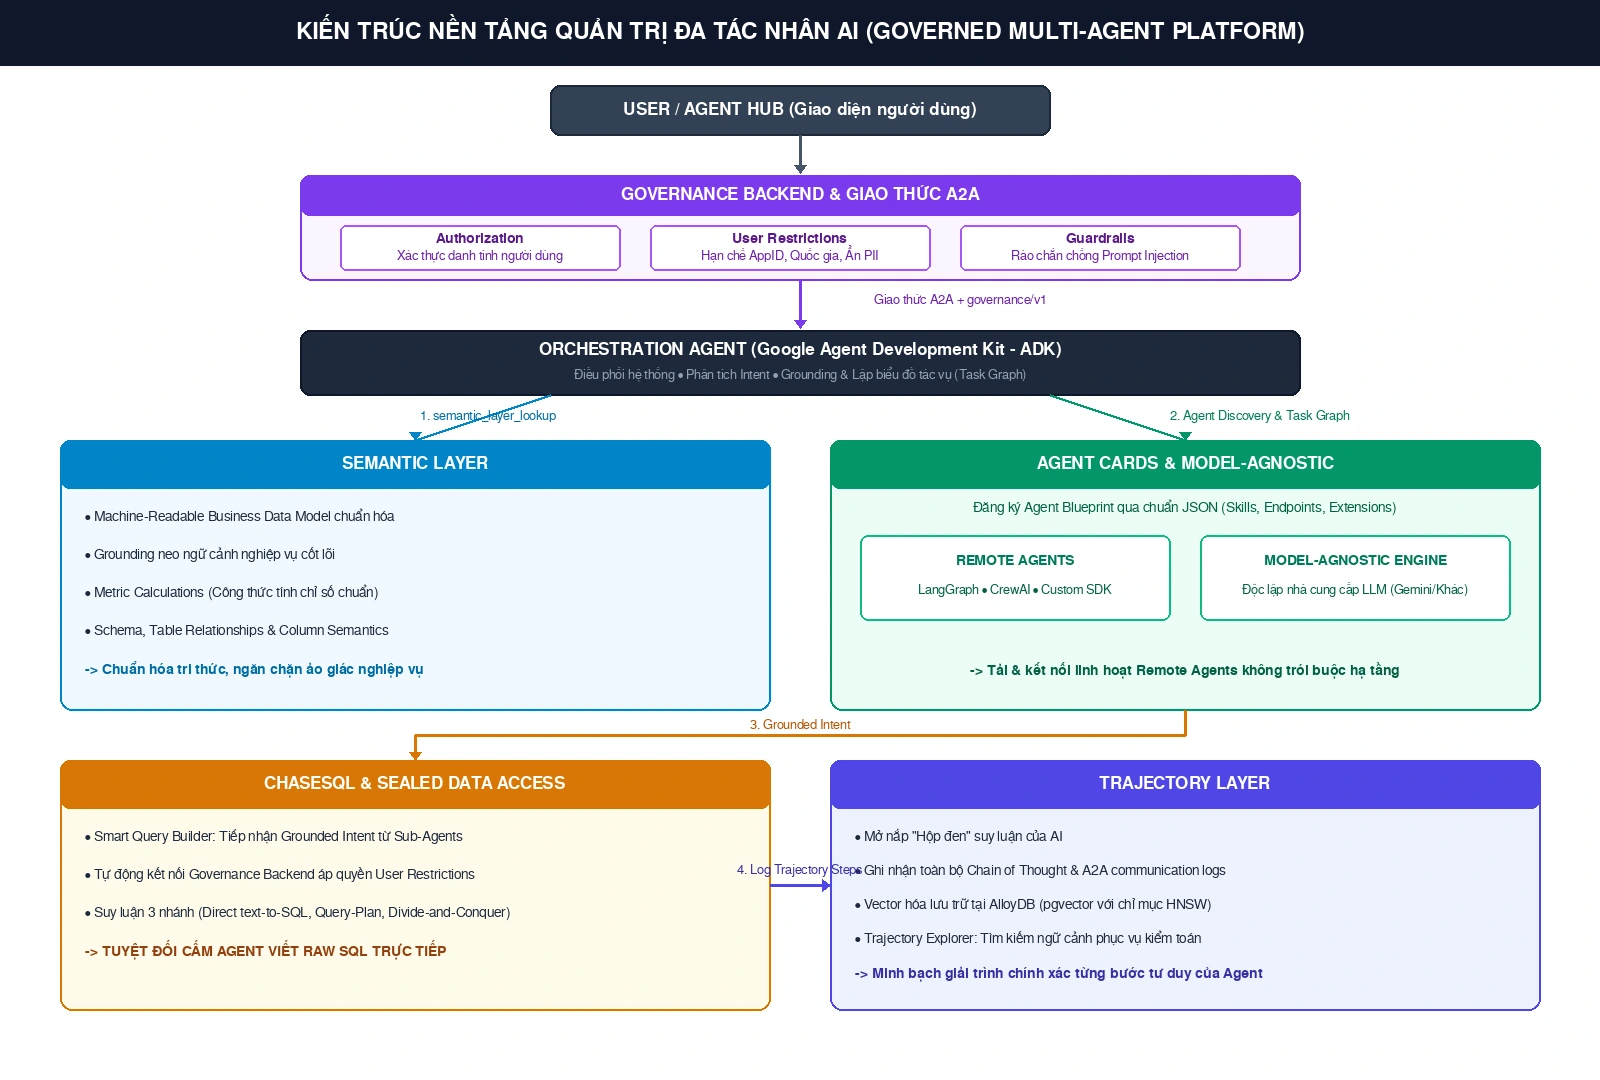
Kiến trúc của AppsFlyer phân tách rõ ràng giữa lớp điều phối, lớp bảo mật, lớp tri thức nghiệp vụ và lớp truy vấn dữ liệu:
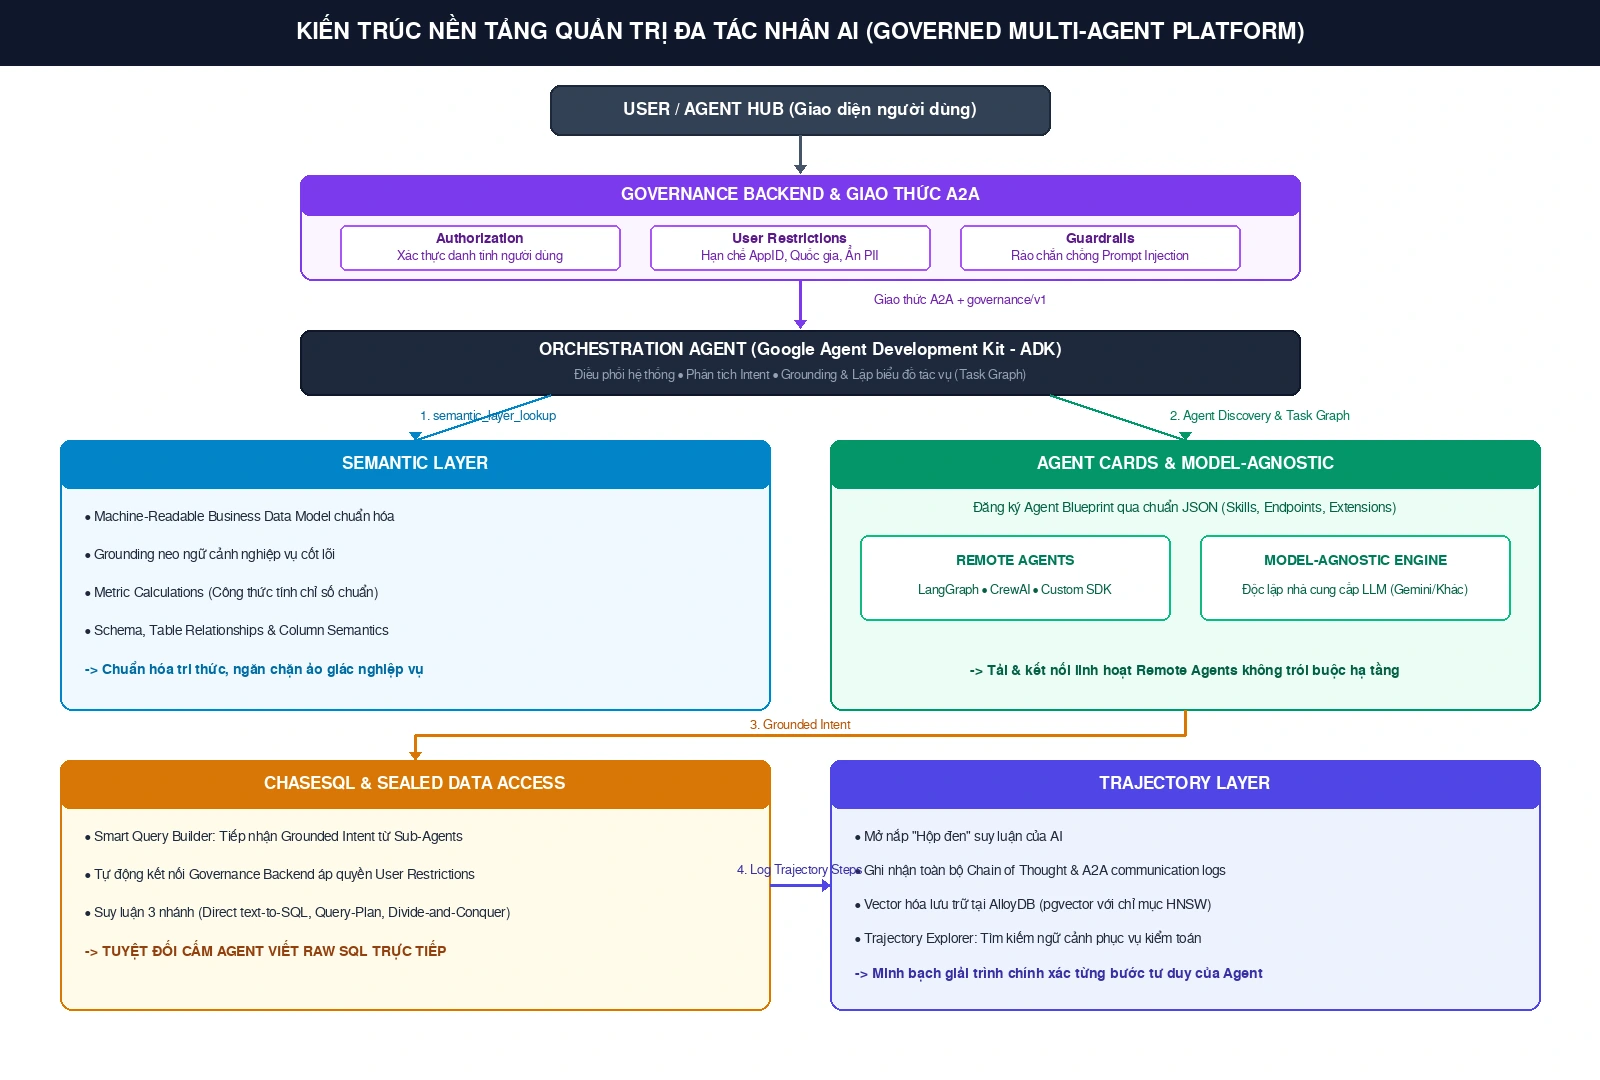
3. Mổ xẻ 5 trụ cột kỹ thuật cốt lõi
Trụ cột 1: Semantic Layer — Điểm tựa chống ảo giác và chuẩn hóa tri thức
Trong hệ thống của AppsFlyer, Semantic Layer không phải là môi trường giả lập, mà là mô hình dữ liệu ngữ nghĩa chuẩn hóa (Machine-Readable Business Data Model).
Mô hình này bao gồm:
- Cấu trúc (Schema) và nhật ký thay đổi của các sản phẩm dữ liệu.
- Công thức tính toán chuẩn của các chỉ số (Metric Calculations).
- Mối quan hệ và ràng buộc giữa các bảng (Table Relationships).
- Ý nghĩa các trường thông tin và danh mục giá trị hợp lệ (Columns & Value Semantics).
Cơ chế hoạt động: Khi Orchestration Agent (Agent điều phối trung tâm, xây dựng trên Google Agent Development Kit - ADK) nhận câu hỏi từ người dùng, bước đầu tiên nó thực hiện không phải là chia việc cho các agent con, mà là gọi công cụ semantic_layer_lookup để Grounding (neo ngữ cảnh).
Nếu câu hỏi nhắc đến "Doanh thu theo nguồn tiếp thị", Orchestrator sẽ đối chiếu vào Semantic Layer để biết chính xác trường dữ liệu nào, bảng nào biểu thị khái niệm này. Điều này đảm bảo Agent luôn lập kế hoạch dựa trên những tài sản dữ liệu thực tế mà doanh nghiệp sở hữu, loại bỏ hoàn toàn việc bịa đặt tên bảng hay logic nghiệp vụ.
Trụ cột 2: Governance Backend & Giao thức A2A — Bảo mật là thuộc tính của hạ tầng
Nhiều hệ thống AI hiện nay cố gắng kiểm soát bảo mật bằng cách đưa các quy định phân quyền vào prompt. Đây là cách làm rủi ro cao vì prompt injection hoặc suy luận sai lệch của model đều có thể vượt qua rào chắn này.
AppsFlyer giải quyết vấn đề này ở tầng giao thức:
- Authorization & Context Propagation: Mọi tác vụ đều đi qua Governance Backend để xác định danh tính và bộ hạn chế quyền của người dùng (User Restrictions).
- Giao thức Agent-to-Agent (A2A): Các Agent trong hệ thống không giao tiếp tự do qua các kênh riêng lẻ mà bắt buộc phải thông qua giao thức chuẩn A2A (HTTP/JSON-RPC). Mọi thông điệp điều phối đều phải đính kèm phần mở rộng
governance/v1mang theo ngữ cảnh phân quyền của người dùng. Tác vụ nào thiếu thông tin này sẽ bị hạ tầng từ chối ngay lập tức.
Trụ cột 3: ChaseSQL & Sealed Data Access — Tuyệt đối cấm Agent viết Raw SQL
Một trong những quyết định kỹ thuật đáng chú ý nhất của AppsFlyer là: Không một Agent nào được phép viết câu lệnh SQL thô gửi thẳng tới BigQuery.
Thay vào đó, luồng truy vấn được niêm phong an toàn thông qua ChaseSQL (Trình dựng truy vấn thông minh lấy cảm hứng từ công trình nghiên cứu CHASE-SQL):
- Tiếp nhận Grounded Intent: Sub-agent chỉ gửi "ý định truy vấn đã chuẩn hóa nghiệp vụ" (ví dụ: Lấy tổng chi phí và doanh thu D7 của ứng dụng X trong 30 ngày qua).
- Tự động áp quyền người dùng (Self-fetching restrictions): ChaseSQL tự kết nối với Governance Backend để lấy quyền hạn của người dùng đang thực thi.
- Sinh truy vấn đa nhánh: ChaseSQL kích hoạt 3 chiến lược suy luận song song:
- Direct text-to-SQL (Chuyển đổi trực tiếp).
- Query-plan reasoning (Suy luận logic theo cách vận hành của Database Engine: quét bảng, join, lọc trước khi sinh SQL).
- Divide-and-conquer (Chia nhỏ câu hỏi phức tạp thành các mẩu truy vấn con rồi ghép lại).
- Cưỡng chế bảo mật từ gốc: ChaseSQL chọn phương án tối ưu và chèn trực tiếp các điều kiện phân quyền (như lọc
app_id, ẩn các cột dữ liệu nhạy cảm) ngay trong quá trình dựng câu lệnh, trước khi câu SQL được gửi tới BigQuery.
Trụ cột 4: Agent Cards & Tính độc lập với Model (Model-Agnostic)
Để tránh hiện tượng các nhóm kỹ thuật tự làm các Agent phân mảnh, AppsFlyer định nghĩa mỗi Agent là một Agent Blueprint (bản thiết kế chuyên biệt cho một năng lực, ví dụ: Cohort Agent, Anomaly Detection Agent, Deep Research Agent).
Mỗi Agent khi tham gia vào nền tảng chỉ cần đăng ký một Agent Card dạng JSON mô tả:
- Endpoint giao tiếp (A2A URL).
- Các phần mở rộng hỗ trợ (Extensions: như A2UI, Governance).
- Danh mục kỹ năng (Skills) kèm ví dụ cụ thể.
Nhờ chuẩn hóa này:
- Một Agent viết bằng bất kỳ framework nào (Google ADK, LangGraph, CrewAI) hoặc chạy ở bất kỳ máy chủ nào đều có thể gia nhập hệ thống như một Remote Agent.
- Hệ thống hoàn toàn không bị trói buộc vào một nhà cung cấp LLM cụ thể. Việc nâng cấp từ Gemini 1.5 lên các thế hệ model mới hơn chỉ là thay đổi cấu hình phía hạ tầng, không yêu cầu viết lại logic nghiệp vụ của Agent.
Trụ cột 5: Trajectory Layer — Mở nắp "hộp đen" bằng Vector Database
Khi giao cho Deep Research Agent tự động phân tích các bài toán phức tạp, một phiên chạy có thể thực hiện từ 100 đến 200 câu truy vấn BigQuery để kiểm tra các giả thuyết khác nhau.
Để đảm bảo tính giải trình và kiểm toán:
- Toàn bộ chuỗi suy luận (Chain of Thought), các tác vụ A2A, câu truy vấn do ChaseSQL sinh ra và kết quả đánh giá đều được ghi lại vào Trajectory Layer.
- Mỗi bước được vector hóa và lưu trữ trong bảng
trajectory_stepstrên AlloyDB (tận dụng pgvector với chỉ mục HNSW). - Ứng dụng thực tế: Người dùng có thể dùng tính năng Trajectory Explorer để đặt câu hỏi ngược lại cho hệ thống: "Tại sao ở bước 35 Agent lại đổi hướng phân tích sang dữ liệu SKAN?". Hệ thống sẽ tìm kiếm tương đồng trên vector để trích dẫn chính xác từng bước tư duy và câu lệnh tương ứng.
4. Minh họa luồng xử lý: Bài toán phân tích sụt giảm ROAS
Để hình dung cách các thành phần phối hợp nhịp nhàng, hãy xem qua bài toán: "Tại sao chỉ số D7 ROAS của game 'Hero Clash' trên kênh TikTok tại thị trường Mỹ lại sụt giảm 25% trong tuần qua?"
Dưới đây là cách toàn bộ hệ thống phối hợp xử lý theo từng bước:
Bước 1: Giao diện và Định danh (User & Governance Backend)
- Agent Hub: Nhận câu hỏi tự nhiên của người dùng. Agent Hub không hề fix cứng logic câu hỏi mà đóng vai trò là giao diện hiển thị động.
- Governance Backend:
- Xác thực danh tính của user.
- Trích xuất các ràng buộc quyền hạn (User Restrictions): Ví dụ user này chỉ được xem app
com.game.heroclash, chỉ được xem dữ liệu tại US, và không được truy cập cột định danh cá nhân (PII). - Bộ quy tắc này cùng các rào chắn (Guardrails) được đóng gói vào phần mở rộng giao thức
governance/v1để truyền đi kèm mọi tác vụ.
Bước 2: Tiếp nhận và "Grounding" (Orchestration Agent & Semantic Layer)
Orchestration Agent (chạy trên Cloud Run bằng Google ADK):
- Intent & Chain of Thought: Phân tích câu hỏi cần giải quyết: tính toán D7 ROAS, so sánh tuần này với tuần trước, phân tích nguyên nhân (có thể do giá thầu tăng, tỷ lệ giữ chân D7 giảm, hoặc gian lận gia tăng).
- Tra cứu Semantic Layer: Trước khi chọn agent nào để chạy, Orchestrator tra cứu Semantic Layer:
- D7 ROAS được định nghĩa chính xác là: Doanh thu in-app tích lũy trong 7 ngày / Chi phí quảng cáo.
- TikTok trong hệ thống ánh xạ sang
media_source = 'tiktok_int'. - Schema liên quan: Bảng
cohort_revenuevà bảngad_spend.
- Nhờ bước này, Orchestrator hiểu đúng dữ liệu nghiệp vụ của AppsFlyer thay vì suy đoán mơ hồ.
Bước 3: Khám phá Agent và Lập kế hoạch (Agent Discovery API & A2A Protocol)
- Agent Discovery API: Orchestrator đối chiếu các năng lực cần thiết với danh mục Agent Cards:
- Tìm thấy Anomaly Agent (chuyên tìm điểm bất thường trong chuỗi thời gian).
- Tìm thấy Cohort Agent (chuyên bóc tách tỷ lệ giữ chân và LTV).
- Tìm thấy Deep Research Agent (chuyên đào sâu vào các yếu tố vi mô như biến động chi phí, gian lận Protect360).
- Task Breakdown: Orchestrator tạo biểu đồ tác vụ (Task Graph):
- Nhánh 1 (Chạy song song): Gọi Cohort Agent lấy dữ liệu doanh thu & retention D7; đồng thời gọi Anomaly Agent quét xem chi phí quảng cáo (Cost) có tăng đột biến không.
- Nhánh 2 (Tuần tự): Lấy kết quả từ Nhánh 1 chuyển cho Deep Research Agent để đối chiếu nguyên nhân gốc.
- Tất cả giao tiếp giữa các agent đều đi qua giao thức chuẩn A2A (Agent-to-Agent), kèm theo context phân quyền
governance/v1.
Bước 4: Truy vấn dữ liệu an toàn (ChaseSQL & BigQuery)
Khi các Sub-agent cần dữ liệu, chúng không tự viết câu lệnh SQL:
- Grounded Intent: Agent chỉ gửi yêu cầu logic: "Lấy tổng chi phí và doanh thu D7 cho app
com.game.heroclash,media_source tiktok_int,country US, từ ngày A đến ngày B". - ChaseSQL (Smart Query Builder):
- Nhận intent và tự động gọi về Governance Backend để lấy quyền hạn của user.
- Sinh ra 3 phương án query (direct text-to-SQL, query-plan reasoning, divide-and-conquer) và chọn phương án tối ưu nhất.
- Cưỡng chế bảo mật ngay trong câu lệnh: ChaseSQL tự động chèn mệnh đề
WHERE country = 'US' AND app_id = 'com.game.heroclash'vào câu SQL trước khi tạo mã hoàn chỉnh. - Gửi câu lệnh đã kiểm soát xuống BigQuery để lấy dữ liệu thực tế.
Bước 5: Ghi vết và Kiểm toán (Trajectory Layer & AlloyDB)
Trong quá trình Deep Research Agent chạy liên tục (có thể tốn từ 20–50 lượt truy vấn để kiểm tra: do giá thầu tăng? do mạng quảng cáo phân phối sai tệp người dùng? hay do gian lận click?):
- Mỗi bước suy luận, mỗi tác vụ A2A, và từng câu query được ChaseSQL tạo ra đều được gửi về Trajectory Layer.
- Toàn bộ hành trình này được vector hóa và lưu vào bảng
trajectory_stepstrên AlloyDB (sử dụng tiện ích mở rộng pgvector với chỉ mục HNSW). - Lợi ích: Người dùng hoặc kỹ sư bảo mật có thể dùng tính năng Trajectory Explorer trên Agent Hub để hỏi: "Tại sao Agent lại kết luận là do chất lượng traffic giảm?", hệ thống sẽ tìm kiếm theo vector và trích dẫn chính xác bước suy luận cùng câu query đã chạy.
Bước 6: Trả kết quả (Notification / A2UI Rendering)
- Sau khi tìm ra nguyên nhân (ví dụ: Do TikTok mở rộng sang tệp đối tượng audience mới khiến D7 retention giảm từ 18% xuống 11%, kéo theo ROAS giảm), Agent chuẩn bị kết quả.
- Thay vì chỉ trả về một đoạn text đơn thuần, Agent đính kèm cấu trúc giao diện khai báo A2UI (Agent-to-UI):
- Biểu đồ đường so sánh Retention D7 giữa 2 tuần.
- Bảng phân tích chi phí và doanh thu theo từng Ad Set.
- Agent Hub (hoặc bot gửi tin nhắn vào Slack/Email) nhận cấu trúc A2UI này và render thành biểu đồ trực quan, an toàn phía client mà không cần lập trình viên phải code riêng giao diện cho từng câu trả lời.
5. Bài học thực tiễn cho doanh nghiệp triển khai AI
Từ mô hình của AppsFlyer, chúng ta có thể rút ra những nguyên tắc quan trọng cho lộ trình ứng dụng AI tại doanh nghiệp:
- Bảo mật phải nằm ở tầng nền tảng, không nằm ở Prompt: Đừng trông đợi LLM tự giác tuân thủ quyền hạn. Hãy khóa quyền truy cập dữ liệu bằng hạ tầng (như cách ChaseSQL và Governance Backend hoạt động).
- Đầu tư vào Semantic Layer trước khi mở rộng số lượng Agent: Một mô hình dữ liệu ngữ nghĩa chuẩn xác là điều kiện tiên quyết để ngăn chặn ảo giác. Nếu dữ liệu nội bộ chưa được định nghĩa rõ ràng, việc bổ sung thêm Agent chỉ làm tăng tốc độ tạo ra thông tin sai lệch.
- Thiết kế theo hướng Module hóa và Độc lập với Model: Sử dụng các chuẩn giao tiếp mở (như A2A hoặc MCP) giúp doanh nghiệp linh hoạt thay thế mô hình LLM bên dưới khi công nghệ tiến hóa, bảo vệ khoản đầu tư dài hạn vào hạ tầng phần mềm.
- Tính minh bạch (Auditability) quyết định khả năng mở rộng: Khả năng kiểm toán chuỗi suy luận của AI là yếu tố cốt lõi giúp ban lãnh đạo và các bộ phận chuyên môn đặt niềm tin vào các đề xuất tự động từ hệ thống.
6. Về Vinh Mekong — Đồng hành chuyển đổi AI & Kiến trúc Dữ liệu
Tại Vinh Mekong, chúng tôi tin rằng việc ứng dụng Trí tuệ Nhân tạo chỉ thực sự mang lại giá trị khi được đặt trên một nền tảng kiến trúc phần mềm vững chắc, dữ liệu chuẩn mực và cơ chế quản trị an toàn. Chúng tôi đồng hành cùng các doanh nghiệp trong việc tư vấn, thiết kế và hiện thực hóa các giải pháp phần mềm, kiến trúc dữ liệu và hệ sinh thái AI có khả năng mở rộng bền vững.
Doanh nghiệp của bạn đang cần tư vấn Kiến trúc & Quản trị AI?
Hãy liên hệ với đội ngũ chuyên gia của Vinh Mekong để xây dựng giải pháp AI Agent safe, governed và tối ưu trên nền tảng Cloud.